Apple Intelligence und On-Device-KI: Chancen und Grenzen für RAG
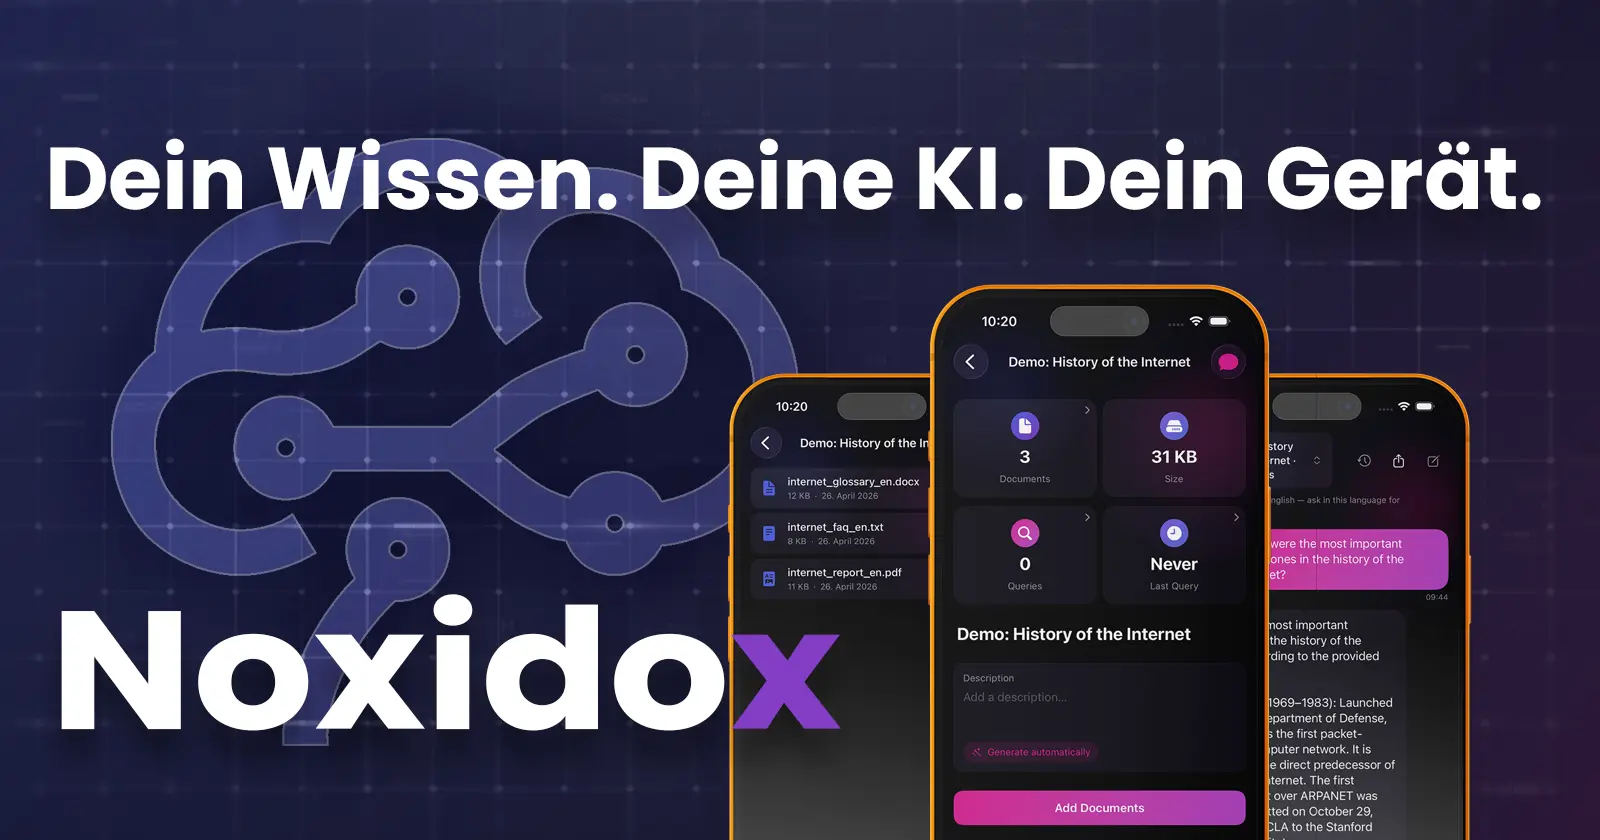
Was ist die Apple Intelligence und was beinhaltet diese? Es ist ein Konzept, welches generative KI direkt auf iPhone, iPad und Mac bringt. Ein wichtiger Bestandteil dabei ist die Möglichkeit, KI-Modelle direkt auf dem Gerät auszuführen. Das bietet Vorteile bei Datenschutz, Geschwindigkeit und Integration, stellt Anwendungen wie die Noxidox App aber auch vor besondere Herausforderungen.
Ich fand, gerade bei der Verarbeitung persönlicher Dokumente ist die Kombination aus On-Device-KI und Retrieval-Augmented Generation (RAG) interessant. Denn die Dokumente können lokal verarbeitet werden, während ein Sprachmodell auf die für eine Anfrage relevanten Informationen zugreift.
Doch die lokale Ausführung hat Grenzen. Insbesondere bei dem verfügbaren Kontextfenster des On-Device-LLMs.
Was ist Apple Intelligence?
Apple Intelligence ist Apples Plattform für generative und kontextbezogene KI-Funktionen. Sie verbindet verschiedene KI-Modelle und Systemfunktionen und ist tief in Apples Betriebssysteme integriert.
Dazu gehören die Foundation Models. Das sind Sprachmodelle (LLMs), die lokal auf kompatiblen Geräten direkt ausgeführt werden können. Für komplexere Aufgaben kann zusätzlich Cloud Computing genutzt werden. Es können dadurch bestimmte KI-Aufgaben lokal auf dem iPhone, iPad oder Mac verarbeitet werden, ohne dass die dafür notwendigen Inhalte an einen externen KI-Anbieter übertragen werden müssen. Das ist insbesondere für persönliche und sensible Informationen interessant.
Reicht die Rechenleistung des Geräts für eine Aufgabe nicht aus, verfolgt Apple zusätzlich den Ansatz von Private Cloud Compute (PCC). Komplexere Berechnungen können dabei auf speziell dafür vorgesehenen Servern ausgeführt werden, wenn der Entwickler diese Option mit integriert hat.
Damit verfolgt Apple einen Ansatz, bei dem Datenschutz und lokale Verarbeitung möglichst eng mit moderner generativer KI verbunden werden.
Genau deswegen wählte ich diesen Ansatz für meine Noxidox App. Dokumente werden lokal verarbeitet und mit der RAG Technologie durchsuchbar machen, während die KI ebenfalls direkt auf dem Gerät arbeitet.
Welche Vorteile bietet Apple Intelligence gegenüber Open-Source-Modellen?
Open-Source-KI-Modelle bieten uns Entwicklern viel Freiheit. Sie können auch auf eigener Hardware betrieben. Auch können diese angepasst und für spezielle Anwendungsfälle optimiert werden. Die Apple Intelligence verfolgt dagegen einen stärker integrierten Ansatz. Gerade auf Apple-Geräten ergeben sich daraus einige besondere Vorteile.
Optimierung für Apple Silicon
Apple kontrolliert sowohl die Hardware als auch große Teile der Softwareplattform. Die Foundation Models können deshalb gezielt auf die Eigenschaften von Apple Silicon CPUs und die dort integrierte Neural Engine optimiert werden. Das ermöglicht die effiziente Ausführung des On-Device KI-Modells auf dem Gerät.
Ein beliebiges Open-Source-Modell kann zwar ebenfalls lokal betrieben werden, muss aber nicht automatisch optimal auf die jeweilige Hardware abgestimmt sein.
Tiefe Integration in iOS und macOS
Die Apple Intelligence ist kein isolierter KI-Dienst. Es ist ein fester Bestandteil des Apple-Ökosystems. Apple bietet entsprechende Frameworks, um die Funktionalität in die eigenen Apps zu integrieren. Dadurch entstehen Möglichkeiten für systemweite KI-Funktionen.
Energieeffiziente lokale KI
KI-Modelle benötigen normalerweise erhebliche Rechenleistung. Auf einem mobilen Gerät ist deshalb nicht nur die Geschwindigkeit entscheidend, sondern auch der Energieverbrauch. Die Optimierung von Modellen und Hardware für Apple-Geräte ermöglicht es, KI-Aufgaben lokal auszuführen, ohne dafür zwangsläufig die Ressourcen eines großen Cloud-Servers zu benötigen.
Die Herausforderung der On-Device-Verarbeitung: Das Kontextfenster
Ein Sprachmodell kann nicht unbegrenzt viele Informationen gleichzeitig verarbeiten. Die Menge an Text, die ein Modell in einer Anfrage berücksichtigen kann, wird durch sein Kontextfenster begrenzt. Bei den On-Device-Modellen von Apple ist dieses Kontextfenster vergleichsweise klein. Für normale KI-Aufgaben ist das häufig kein großes Problem. Bei der Verarbeitung großer Dokumentensammlungen wird diese Einschränkung jedoch besonders relevant.
Warum ist das für RAG wichtig?
Das Grundprinzip ist einfach:
- Eine Frage wird gestellt.
- Das System sucht in den vorhandenen Dokumenten nach relevanten Informationen.
- Die gefundenen Textstellen werden als Kontext an das Sprachmodell übergeben.
- Das Modell erstellt daraus eine Antwort.
Das Sprachmodell muss also nicht sämtliche Dokumente kennen. Es erhält nur die Informationen, die für die aktuelle Frage relevant sind.Genau hier entsteht bei einem kleinen Kontextfenster eine Herausforderung.
Nicht alle relevanten Informationen passen in den Kontext
Stellen wir uns eine Dokumentensammlung mit mehreren hundert PDFs vor. Ein Nutzer fragt beispielsweise: „Welche Änderungen gab es zwischen den Verträgen aus 2023 und 2025?“
Das RAG-System muss zunächst die relevanten Dokumente und Textabschnitte finden.
Bei einem sehr großen Kontextfenster könnten anschließend große Mengen dieses Materials an das Sprachmodell übergeben werden. Bei einem kleinen On-Device-Kontextfenster ist das nicht möglich. Das System muss deshalb wesentlich genauer entscheiden, welche Informationen tatsächlich an das Sprachmodell weitergegeben werden. Damit verschiebt sich ein Teil der Aufgabe vom LLM in die Retrieval-Schicht.
Warum gutes Retrieval bei On-Device-KI besonders wichtig ist
Bei einem RAG-System mit begrenztem Kontextfenster reicht es nicht aus, einfach möglichst viele Suchergebnisse an das Sprachmodell zu übergeben. Die relevanten Informationen müssen möglichst präzise identifiziert und priorisiert werden. Dafür habe ich bei Noxidox unterschiedliche Suchverfahren miteinander kombiniert.
Eine semantische Suche findet beispielsweise Textstellen, die inhaltlich zu einer Frage passen, auch wenn die verwendeten Begriffe unterschiedlich sind.
Eine klassische Volltextsuche kann dagegen konkrete Begriffe besonders zuverlässig finden.
Bei Noxidox hilft die Kombination beider Verfahren, um aus einer großen Dokumentensammlung genau die Informationen herauszufiltern, welche für die aktuelle Anfrage benötigt werden. Das Ergebnis wird anschließend auf einen kompakten Kontext reduziert, den das On-Device-LLM tatsächlich verarbeiten kann. Vereinfacht sieht die Architektur damit so aus:
Dokumente → Suche → Relevanzbewertung → Kontextaufbereitung → On-Device-LLM → Antwort
Das Sprachmodell muss also nicht möglichst viele Informationen bekommen. Es muss die richtigen Informationen bekommen.
Fazit: On-Device-KI braucht intelligentes Retrieval
Die Apple Intelligence zeigt, dass moderne generative KI zunehmend direkt auf unseren Geräten stattfinden kann. Für Anwendungen mit sensiblen Informationen ist das besonders interessant, weil Daten lokal verarbeitet werden können und nicht zwangsläufig an externe KI-Dienste übertragen werden müssen.
Gleichzeitig hat eine On-Device-KI andere Rahmenbedingungen als die großen Cloud-Modelle. Das vergleichsweise kleine Kontextfenster der Apple-Modelle stellt insbesondere RAG-Anwendungen vor eine Herausforderung.
Die Lösung besteht nicht unbedingt darin, ein größeres Modell einzusetzen. Stattdessen wird die Qualität des Retrievals entscheidend.
Denn ein RAG-System muss nicht das gesamte Wissen an das Sprachmodell übergeben. Es muss dafür sorgen, dass genau die richtigen Informationen im richtigen Moment im Kontext des Modells landen.
Das ist eine der spannendsten Eigenschaften lokaler KI: Die Intelligenz eines Systems entsteht nicht allein durch das Sprachmodell, sondern durch das Zusammenspiel aus Dokumenten, Retrieval, Kontext und KI-Modell.
Für Noxidox bedeutet das: Die Stärke der On-Device-KI liegt nicht darin, möglichst große Datenmengen an ein Modell zu übergeben. Sie liegt darin, relevante Informationen lokal zu finden und sie effizient für das KI-Modell bereitzustellen.
Weiterführende technische Informationen
Apple Developer Documentation: Foundation Models Session
Apple Developer Documentation: Private Cloud Compute
Kommentare
Noch keine Kommentare. Schreib den ersten!